Plataforma de datos Spark, Kafka y Airflow
Procesa datos por lotes y en tiempo real con Spark, Kafka y Airflow y los organiza en capas de calidad creciente (arquitectura Medallion) sobre Delta Lake.
- Apache Spark4.0.1
- Delta Lake4.0.0
- Apache Kafka4.1.1
- Apache Airflow3.0.6
- MinIOS3 local
- SQL Server2022
- DockerCompose
- LicenseMIT
Problema
Mantener un catálogo vivo de metadatos combinando fuentes estructuradas, semiestructuradas y eventos en tiempo real.
Arquitectura
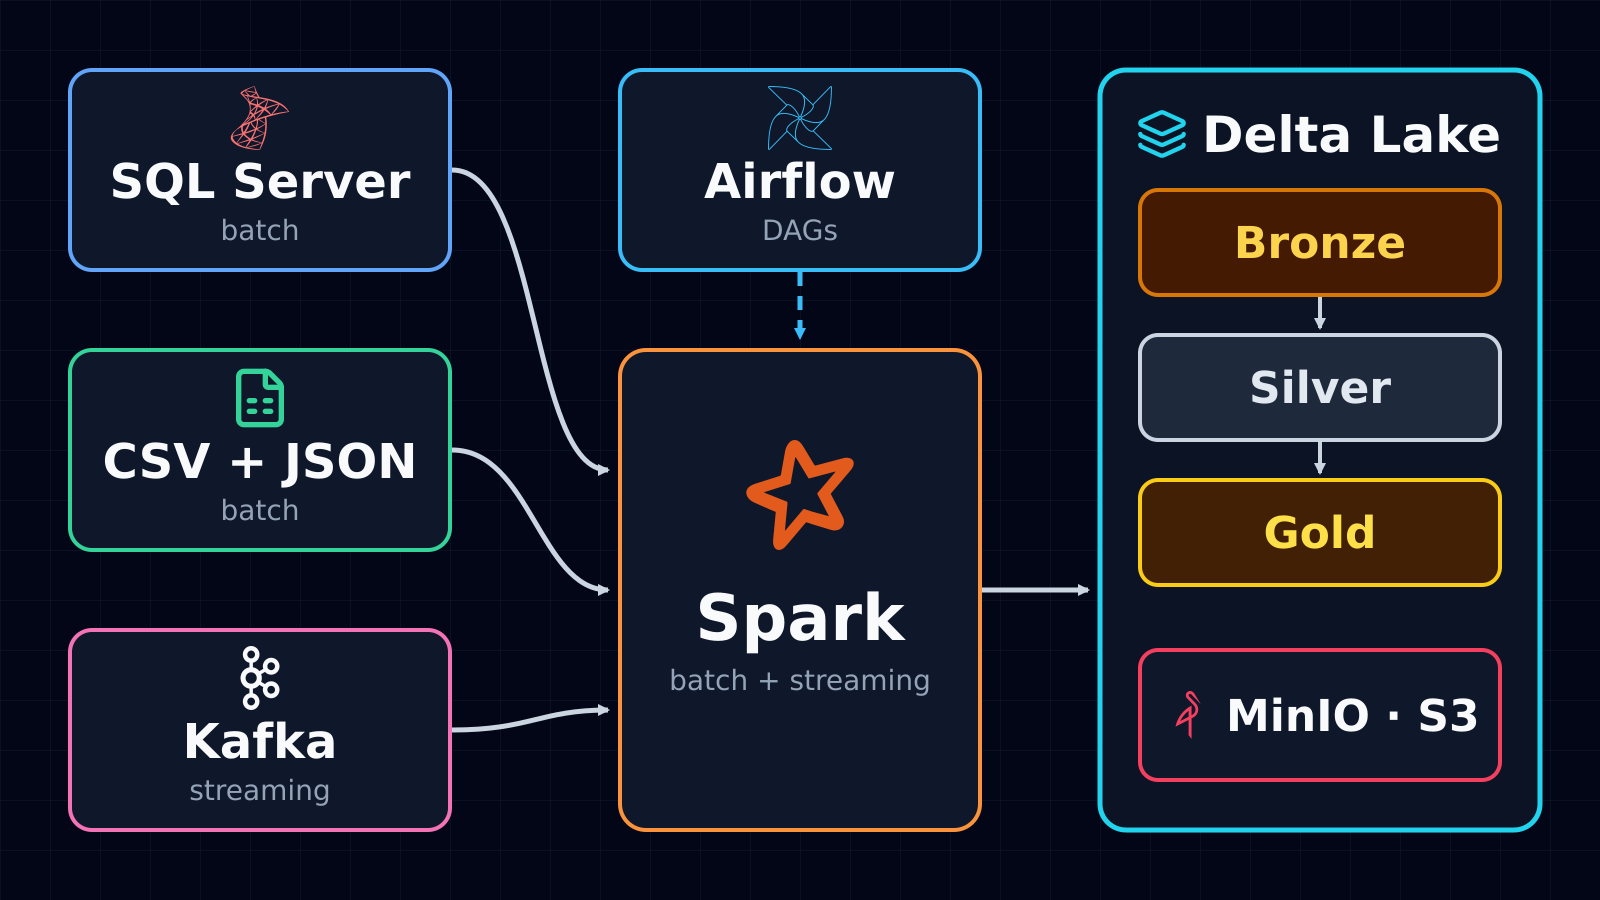
SQL Server, CSV y Kafka alimentan jobs Spark que publican capas Bronze, Silver y Gold sobre Delta Lake y MinIO. Airflow orquesta los flujos batch.
Flujo de datos
Fuentes → ingesta batch o streaming → Spark → Delta Lake Medallion → previews Gold verificables.
Resultados
3
Patrones de ingesta
SQL batch incremental, CSV batch y Kafka streaming
Ver fuente3
Capas de datos
Bronze, Silver y Gold en cada pipeline
Ver fuenteContribución y autoría
- Diseño del caso de uso y de la arquitectura Medallion
- Implementación de los jobs Spark y de los DAGs de Airflow
- Integración reproducible de Kafka, SQL Server, MinIO y Delta Lake
Evidencias


Limitaciones
- • Entorno local reproducible con datos de demostración, no una plataforma empresarial en producción
- • Las credenciales incluidas son exclusivamente valores locales de desarrollo
Stack
https://github.com/alonsomarcosm99/spark-kafka-airflow-data-platform